
machine learning2 min read
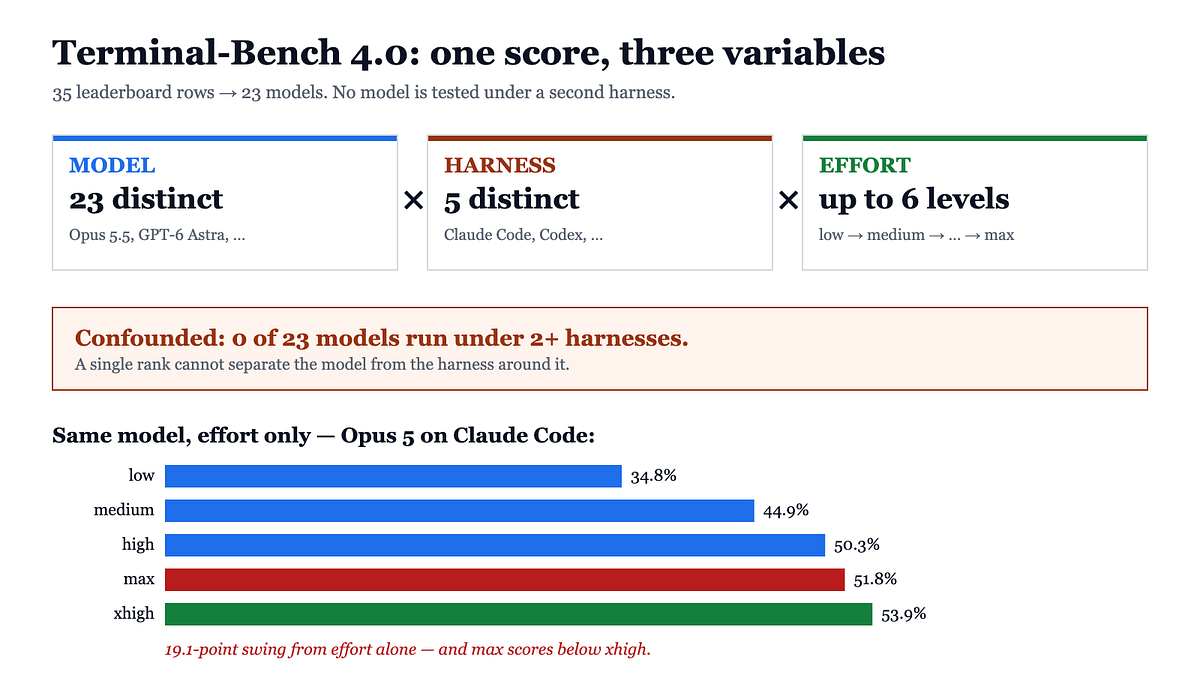
Terminal-Bench 4.0 Ranks 35 Setups, Not 23 Models
Terminal-Bench 4.0 Ranks 35 Setups, Not 23 Models Its own leaderboard never runs one model under two harnesses, and the same Opus 5 spans 34.8% to 53.9% on reasoning effort alone. One script, run …


By Chew Loong Nian - AI ENGINEERTowards AI
Read the full story
Originally published by Towards AI on Oct 24, 2026.
Comments
Sign in to join the discussion.